
| 일 | 월 | 화 | 수 | 목 | 금 | 토 |
|---|---|---|---|---|---|---|
| 1 | 2 | 3 | ||||
| 4 | 5 | 6 | 7 | 8 | 9 | 10 |
| 11 | 12 | 13 | 14 | 15 | 16 | 17 |
| 18 | 19 | 20 | 21 | 22 | 23 | 24 |
| 25 | 26 | 27 | 28 | 29 | 30 | 31 |
- frontend
- react
- TechBlog
- NextJs
- 리팩토링
- 이미지최적화
- fe
- 리액트
- NextImage
- WebP
- 비동기처리
- 데이터캐싱
- 최적화
- Refactoring
- 프론트엔드개발
- 프론트엔드성능
- refresh token
- TanStackQuery
- react성능최적화
- reactquery
- frontenddevelopment
- lighthouse
- Next
- 프론트엔드
- useEffect
- JavaScript
- RTR
- JWT
- 성능최적화
- 프론트엔드개발자
- Today
- Total
juncci 님의 블로그
홈은 계속 보여야 한다: SSR 환경에서 AI 추천 API의 지연과 실패에 대응하기 본문
RE-FIT 서비스 홈에는 사용자에게 적합한 전문가를 보여주는 AI 기반 추천 영역이 있습니다.
추천 데이터를 첫 화면부터 제공하기 위해 해당 영역은 클라이언트에서 별도로 요청하는 구조가 아니라, Next.js 서버 컴포넌트에서 추천 API를 호출한 뒤 홈 HTML에 포함하는 SSR 구조로 구현했습니다.
// src/app/page.tsx
<Suspense fallback={<ExpertRecommendationsSkeleton />}>
  <ExpertRecommendationsServer />
</Suspense>
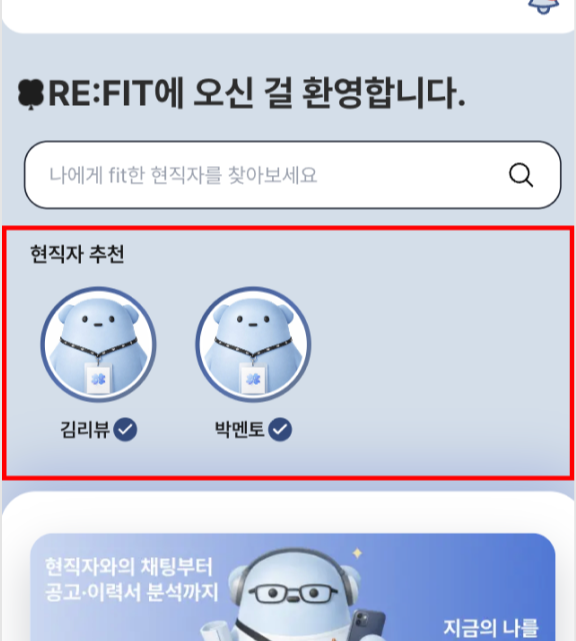
이 구조는 사용자가 홈에 진입했을 때 추천 결과를 빠르게 확인할 수 있다는 장점이 있습니다. 하지만 개발과 테스트 과정에서 AI 추천 API의 응답이 지연되거나 간헐적으로 504 오류가 발생했습니다.
처음에는 추천 영역에만 영향을 주는 문제라고 생각했습니다. 그러나 실제로 측정해 보니 추천 API의 지연이 홈 HTML 응답 시간에도 영향을 주고 있었습니다.
추천 API의 지연이 왜 홈 전체의 문제가 되었을까?
기존 구조에서는 사용자가 홈에 진입할 때 다음 과정이 진행됐습니다.
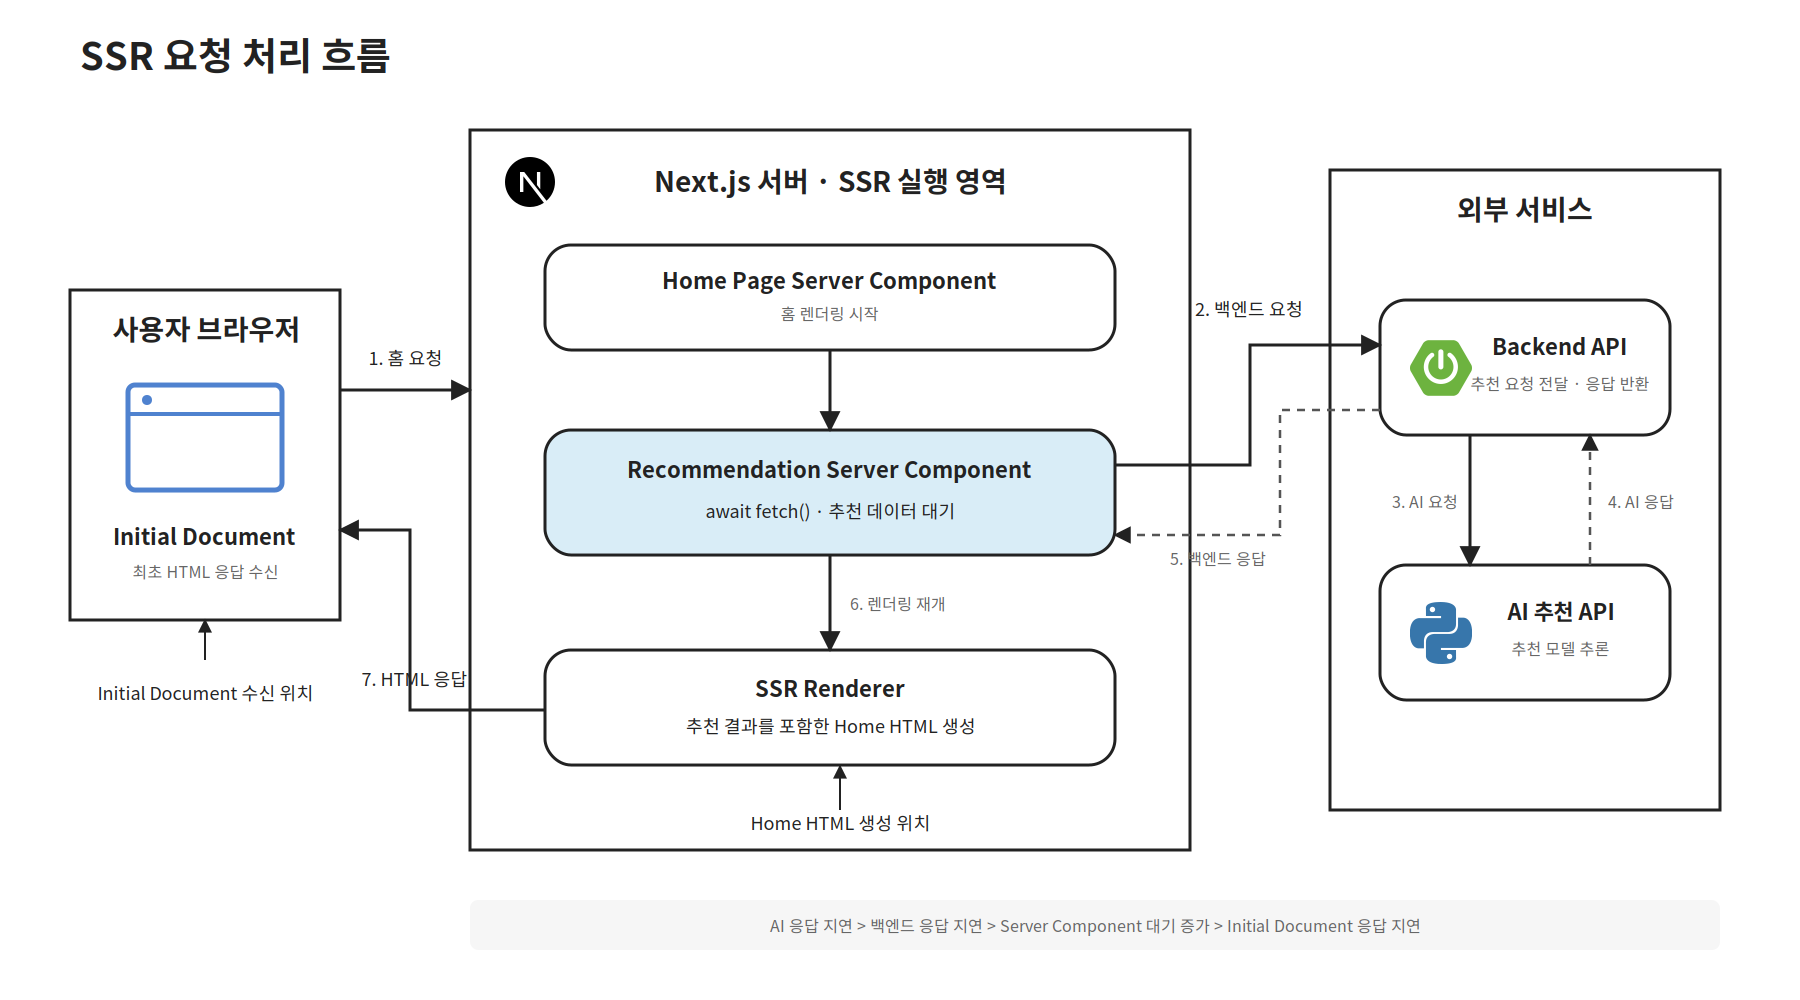
사용자 홈 진입
→ 홈 SSR 시작
→ 전문가 추천 서버 컴포넌트 실행
→ AI 추천 API 호출
→ 추천 데이터가 포함된 HTML 응답
AI 추천 API가 정상적으로 응답하면 문제가 없었습니다. 하지만 API 응답이 늦어지면 서버 컴포넌트도 데이터를 기다려야 했고 결과적으로 브라우저가 홈 HTML을 전달받는 시점까지 늦어졌습니다.
개선 전 실제 홈 HTML 요청에서 Chrome DevTools로 측정한 결과는 다음과 같았습니다.
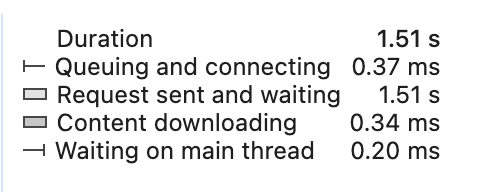
전체 요청 시간 1.51초 중 대부분이 Request sent and waiting 구간에서 발생했습니다.
반면 응답 본문을 내려받는 시간은 0.34ms, 메인 스레드를 기다린 시간은 0.20ms에 불과했습니다. 응답 데이터가 크거나 브라우저 렌더링 작업이 무거워서 느린 것이 아니라 서버가 HTML 응답을 준비하는 과정에서 대부분의 시간이 소비되고 있었습니다.
측정 결과를 기존 구조와 연결하면 다음과 같습니다.
AI 추천 API 응답 지연
→ 추천 서버 컴포넌트가 데이터 대기
→ 홈 HTML 생성 지연
→ Initial document 응답 지연
→ TTFB 증가
→ 사용자가 홈 화면을 확인하는 시점 지연
Suspense로 추천 영역을 감싸고 있었지만 실제 홈 document 요청에서는 추천 API의 지연이 서버 응답 대기 시간으로 나타났습니다. 따라서 단순히 skeleton을 제공하는 것만으로는 현재 구조의 지연 문제를 충분히 막지 못했습니다.
문제의 핵심은 “AI 추천 API가 가끔 느리다”가 아니었습니다.
홈의 일부인 추천 기능이 외부 API의 응답 속도와 가용성에 직접 의존하고 있었고 추천 API의 문제가 홈 초기 렌더링 경험으로 전파되고 있다는 점이었습니다.
홈의 모든 데이터가 같은 중요도를 가져야 할까?
해결 방향을 고민하면서 올리브영 온라인몰의 전시, 그리고 백엔드 여정을 참고했습니다.
올리브영 홈은 여러 비즈니스 로직과 외부 시스템을 조합해 하나의 화면을 제공합니다. 기존에는 특정 로직에서 지연이 발생하면 홈 전체를 제공하지 못할 수 있었고 이를 해결하기 위해 홈 데이터를 다음과 같이 구분했습니다.
- 모든 사용자에게 동일하고 빠르게 제공할 수 있는 Static Data
- 사용자마다 다르며 여러 시스템에 의존하는 Personal Data
개인화 데이터는 여러 비즈니스 로직과 시스템을 거쳐야 하므로 응답 속도를 항상 보장하기 어렵습니다. 따라서 올리브영은 데이터의 성격에 따라 API와 fallback을 분리하고 일부 시스템이 실패해도 홈은 계속 노출되는 구조를 설계했습니다.
본 서비스의 전문가 추천도 같은 관점에서 바라볼 수 있었습니다.
추천 결과는 사용자마다 달라지는 개인화 데이터지만 홈의 핵심 기능은 아닙니다. 추천 API가 느리거나 실패했다는 이유로 홈 진입까지 영향을 받는 것은 기능의 중요도와 의존 관계가 맞지 않는 구조였습니다.
또한 같은 사용자가 짧은 시간 안에 홈에 다시 진입할 때 추천 결과가 매번 완전히 달라질 필요도 없었습니다.
이를 바탕으로 다음 기준을 세웠습니다.
- 홈의 기본 기능은 추천 API 상태와 관계없이 사용할 수 있어야 한다.
- 짧은 시간 안의 반복 진입에는 이전 추천 데이터를 재사용할 수 있다.
- 장애 상황에서는 최신성보다 홈의 가용성을 우선한다.
- 최신 데이터를 가져오지 못하면 최근 추천을 제공한다.
- 최근 추천도 없다면 추천 영역만 비우고 홈 렌더링은 유지한다.
외부 AI API의 장애를 완전히 제거하는 것이 아니라, 장애가 사용자 경험 전체로 전파되는 범위를 제한하는 것이 목표였습니다.
운영 장애를 기다리지 않고 재현하기
간헐적으로 발생하는 지연과 504 오류를 개선하려면 같은 조건에서 개선 전후를 반복 비교할 수 있어야 했습니다.
실제 AI 추천 API가 다시 실패하기를 기다리는 대신 추천 API의 상태를 제어할 수 있는 mock upstream과 실험 대시보드를 구성했습니다.
실험 시나리오는 다음과 같습니다.
| 시나리오 | 동작 | 재현하려는 상황 |
| normal | 즉시 성공 | 추천 API 정상 |
| slow | 지정한 시간만큼 지연 후 성공 | AI 추천 응답 지연 |
| error | 항상 실패 | 504 또는 upstream 장애 |
| flaky | 설정한 확률로 실패 | 간헐적 504 |
비교 대상도 두 구조로 나눴습니다.
| 구분 | 구조 |
| Before | 홈 진입마다 AI 추천 API 호출 |
| After | 30초 fresh cache와 5분 stale fallback 적용 |
대시보드에서는 동일한 시나리오를 반복 실행한 뒤 다음 지표를 비교했습니다.
- 평균 추천 준비 시간
- p50·p95 추천 준비 시간
- upstream 성공 여부
- 홈 렌더링 성공 여부
- cache hit rate
- stale fallback rate
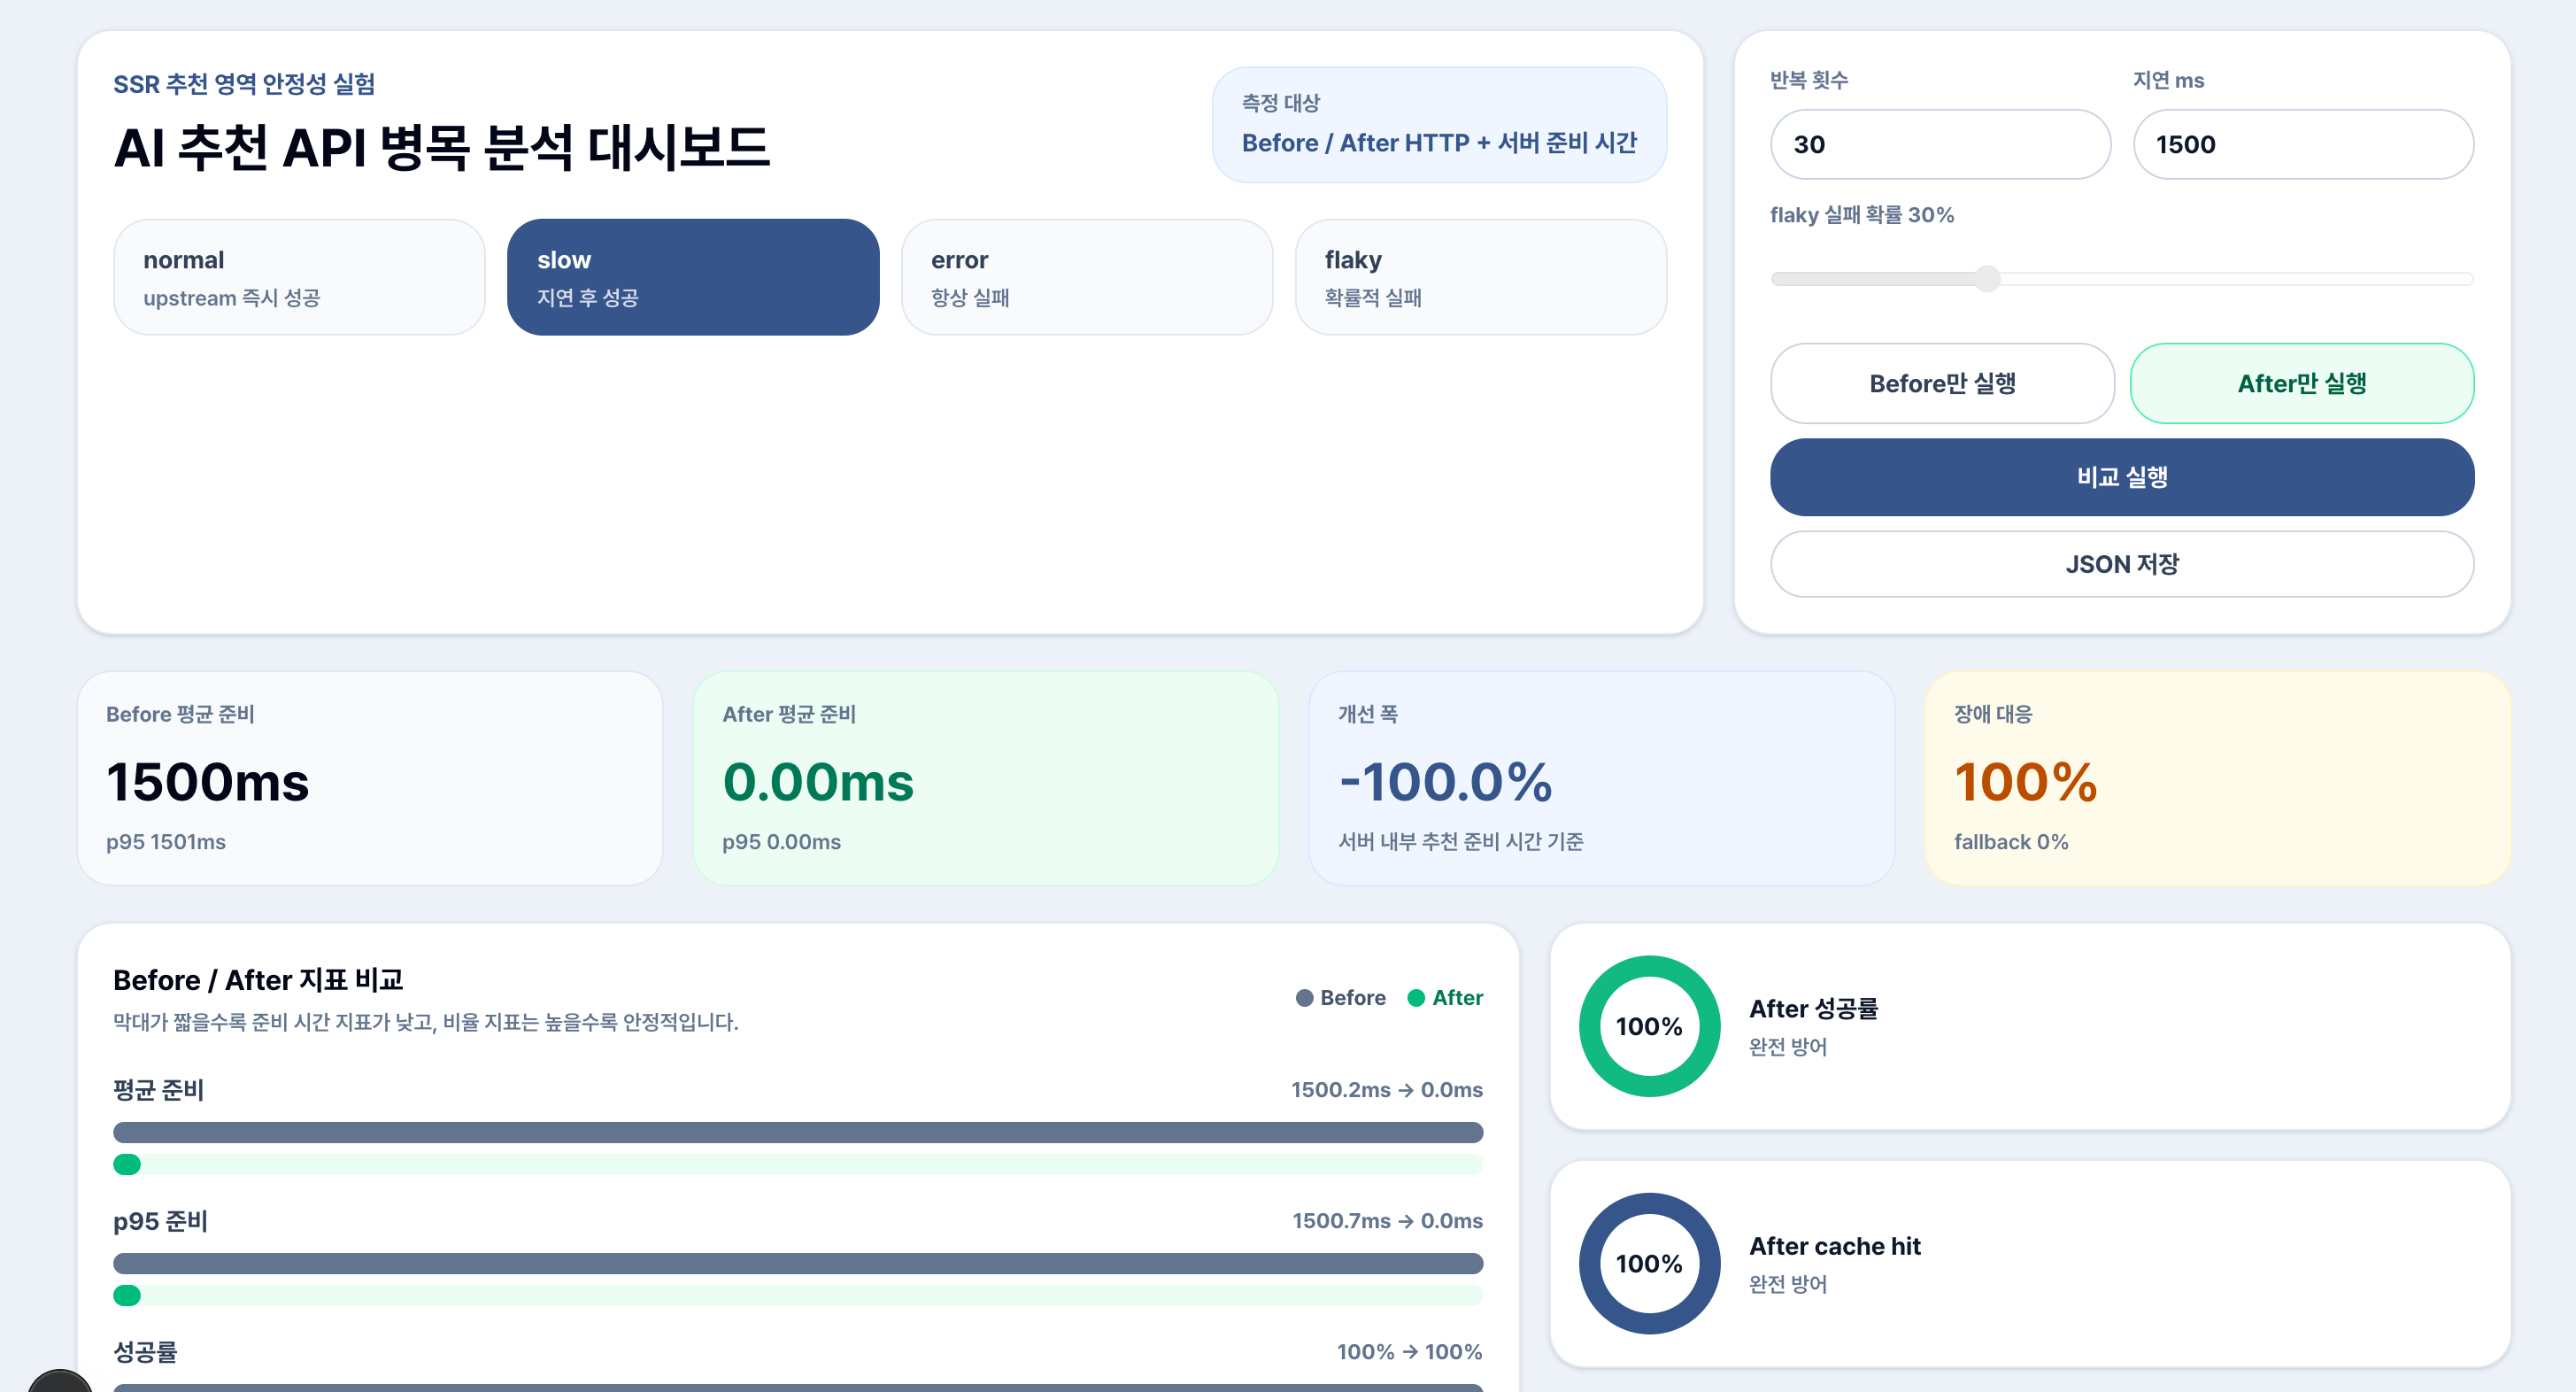
이때 브라우저에서 측정한 요청 시간과 서버 내부에서 측정한 추천 준비 시간을 구분했습니다.
| 지표 | 의미 |
| renderReadyMs | 서버 내부에서 추천 데이터를 준비한 시간 |
| upstreamDurationMs | AI 추천 API를 기다린 시간 |
| Performance Duration | 브라우저에서 관찰한 전체 요청 시간 |
| Request sent and waiting | 브라우저가 서버의 HTML 응답을 기다린 시간 |
브라우저의 Performance Duration만으로는 요청이 오래 걸렸다는 사실만 알 수 있을 뿐 지연이 네트워크·SSR 렌더링·추천 API 중 어디에서 발생했는지는 판단하기 어려웠습니다. 이에 서버에서는 전체 추천 준비 시간인 renderReadyMs와 그중 AI 추천 API를 기다린 시간인 upstreamDurationMs를 각각 기록했습니다.
예를 들어 브라우저의 Request sent and waiting 시간이 길어진 시점에 서버의 upstreamDurationMs도 함께 증가했다면 브라우저가 HTML을 늦게 받은 주된 원인이 AI 추천 API의 응답 지연이라는 점을 확인할 수 있습니다. 반대로 브라우저의 대기 시간은 길지만 upstreamDurationMs가 짧다면 추천 API 외의 SSR 처리, 네트워크 또는 배포 환경을 추가로 확인해야 합니다.
이처럼 브라우저의 전체 요청 시간과 서버 내부 구간별 시간을 함께 비교해, 사용자에게 나타난 SSR 지연이 실제로 추천 API의 대기 시간에서 비롯되었는지 구분할 수 있었습니다.
추천 데이터의 최신성과 가용성 구분하기
캐시를 적용하기 전에 추천 데이터가 어느 정도까지 최신이어야 하는지 판단했습니다.
전문가 추천은 사용자별 데이터이지만 같은 사용자가 30초 안에 홈을 다시 방문할 때마다 새로운 결과를 계산할 필요는 없었습니다.
반면 추천 API 장애로 홈 응답이 늦어지거나 추천 영역이 실패하는 것은 사용자 경험에 더 큰 영향을 줬습니다.
따라서 추천 데이터를 세 가지 상태로 구분했습니다.
Fresh data
생성된 지 30초 이내인 추천 데이터입니다. 동일한 사용자와 동일한 추천 조건으로 다시 요청하면 AI 추천 API를 호출하지 않고 바로 반환합니다.
Stale data
30초의 fresh 기간은 지났지만 생성 후 5분 이내인 데이터입니다. 정상 상황에서는 새 데이터를 요청하지만, AI 추천 API가 실패하면 최근 추천을 fallback으로 사용합니다.
Fallback data
AI 추천 API가 실패하고 stale 데이터도 없을 때 사용하는 빈 추천 데이터입니다. 추천 결과는 표시하지 못하더라도 홈 컴포넌트의 렌더링은 유지합니다.
전체 흐름은 다음과 같습니다.
30초 이내 fresh cache 존재
→ 캐시된 추천 즉시 반환

fresh cache 없음
→ AI 추천 API 호출

API 성공
→ 새 추천을 캐시에 저장하고 반환

API 실패 + 5분 이내 stale cache 존재
→ 최근 추천 반환

API 실패 + stale cache 없음
→ 빈 추천 데이터 반환
이번에 적용한 방식은 Circuit Breaker가 아닙니다.
Circuit Breaker는 일정 횟수 이상의 실패를 감지하면 회로를 열어 외부 API 호출 자체를 중단하고 일정 시간 후 일부 요청만 허용해 복구 여부를 확인합니다. 현재 구조에는 CLOSED, OPEN, HALF_OPEN과 같은 상태 전이가 없습니다.
따라서 이번 작업은 정확히 말하면 다음과 같습니다.
Fresh cache와 stale-if-error fallback을 이용해 AI 추천 API의 지연과 실패가 홈으로 전파되는 범위를 제한한 작업
Fresh cache로 반복 호출 제거하기
추천 API 응답은 서버 메모리의 Map에 저장했습니다.
const RECOMMENDATIONS_CACHE_TTL_MS = 30_000;
const RECOMMENDATIONS_STALE_IF_ERROR_MS = 5 * 60_000;
const MAX_CACHE_ENTRIES = 500;

type CachedRecommendation = {
  cachedAt: number;
  body: ExpertRecommendationsResponse;
};

const recommendationsCache = new Map<
  string,
  CachedRecommendation
>();
같은 사용자와 동일한 추천 조건에 대한 cache key를 만들고 생성 후 30초가 지나지 않은 데이터가 있으면 upstream 호출을 생략했습니다.
const freshCache = cacheEnabled
  ? getCachedRecommendation(
      cacheKey,
      RECOMMENDATIONS_CACHE_TTL_MS,
    )
  : { hit: false, body: null };

if (freshCache.hit && freshCache.body) {
  logRecommendationMetric('info', {
    cache: 'HIT',
    durationMs: nowMs() - startMs,
    count: freshCache.body.recommendations.length,
  });

  return (
    <ExpertRecommendations
      recommendations={
        freshCache.body.recommendations
      }
    />
  );
}
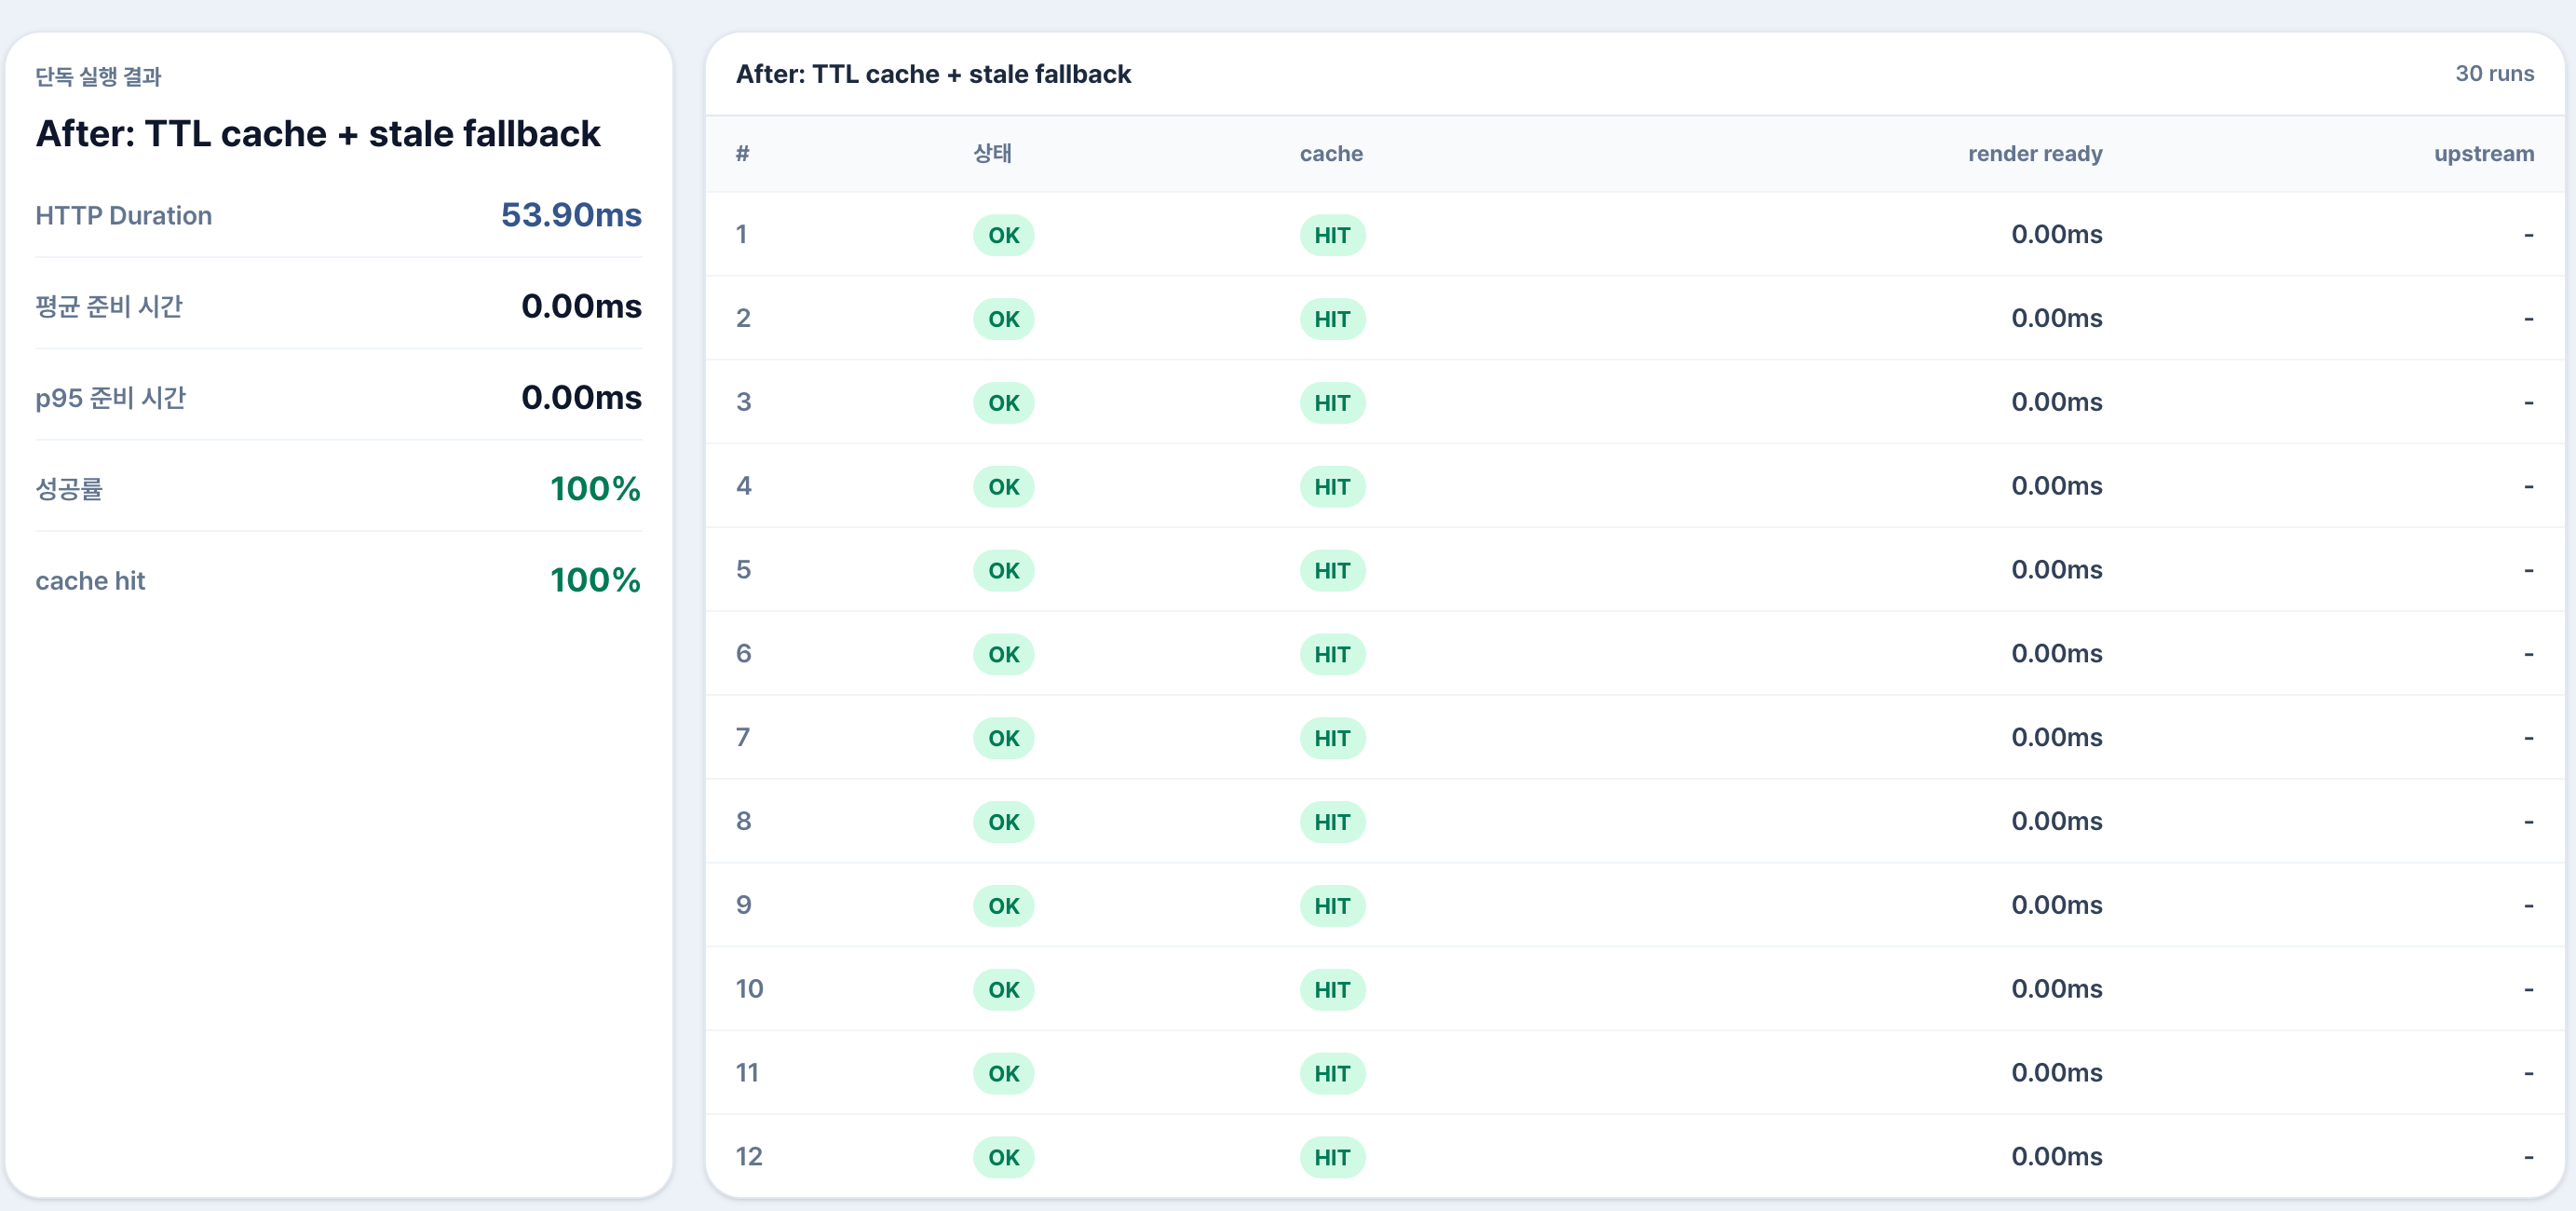
기존에는 같은 사용자가 홈에 다시 진입하더라도 AI 추천 API 응답을 기다려야 했습니다. 개선 후에는 30초 이내의 반복 진입에서 네트워크 호출 대신 메모리 조회만 수행합니다.
실험 대시보드에서 0ms로 표시되는 결과는 네트워크 요청이 0ms에 끝났다는 의미가 아닙니다. 서버 내부에서 추천 데이터를 준비하는 과정이 Map 조회 수준으로 줄어 측정 단위상 0ms에 가깝게 반올림됐다는 의미입니다.
실패하면 최근 추천으로 전환하기
Fresh cache가 없으면 AI 추천 API를 호출합니다. 호출에 성공하면 응답을 캐시에 저장하고 실패하면 최근 5분 이내의 데이터가 있는지 확인합니다.
try {
  data = await apiFetch<
    ExpertRecommendationsResponse
  >(url, {
    method: 'GET',
    cache: 'no-store',
    headers: accessToken
      ? { Authorization: `Bearer ${accessToken}` }
      : undefined,
  });

  setCachedRecommendation(cacheKey, data);
} catch (error) {
  const staleCache = cacheEnabled
    ? getCachedRecommendation(
        cacheKey,
        RECOMMENDATIONS_STALE_IF_ERROR_MS,
      )
    : { hit: false, body: null };

  if (staleCache.hit && staleCache.body) {
    data = staleCache.body;

    logRecommendationMetric('warn', {
      cache: 'STALE_FALLBACK',
      durationMs: nowMs() - startMs,
      count: data.recommendations.length,
    });
  }
}
이제 AI 추천 API에서 504 오류가 발생해도 최근 추천 데이터가 있다면 해당 데이터를 사용자에게 제공합니다.
사용자는 최신 추천 대신 직전에 제공받았던 추천을 보게 되지만 추천 영역이 갑자기 사라지거나 홈 전체가 실패하는 경험은 피할 수 있었습니다.
stale 데이터도 존재하지 않는 최초 요청에서는 빈 추천 데이터를 사용합니다.
const FALLBACK_DATA: ExpertRecommendationsResponse = {
  user_id: 0,
  recommendations: [],
  total_count: 0,
  evaluation: {},
};
이를 통해 장애 범위를 다음과 같이 변경했습니다.
개선 전
AI 추천 API 실패
→ 추천 데이터 수신 실패
→ 홈 SSR 과정에 영향

개선 후
AI 추천 API 실패
→ 최근 추천 확인
→ 최근 추천 또는 빈 데이터 반환
→ 홈 렌더링 유지
대체 응답을 정상 응답과 구분하기
사용자에게 홈 화면이 정상적으로 보이더라도 AI 추천 API 장애가 해결된 것은 아닙니다.
stale 데이터를 반환한 요청까지 모두 정상 성공으로 기록하면 실제 upstream 장애가 가려질 수 있습니다. 따라서 추천 데이터가 어떤 경로로 반환됐는지 구조화 로그로 기록했습니다.
function logRecommendationMetric(
  level: 'info' | 'warn',
  metric: Record<
    string,
    string | number | boolean | undefined
  >,
) {
  const payload = {
    event: 'ssr_expert_recommendations',
    ...metric,
  };

  console[level](
    `[SSR_EXPERT_RECOMMENDATIONS_METRIC] ${
      JSON.stringify(payload)
    }`,
  );
}
로그에는 다음 정보를 포함했습니다.
cache:
  HIT
  MISS_FETCHED
  STALE_FALLBACK
  MISS_ERROR_NO_STALE

durationMs
upstreamDurationMs
hasAuth
query
count
path
이를 통해 두 종류의 성공을 구분할 수 있습니다.
- upstream success: AI 추천 API가 새로운 추천을 정상 반환
- render success: 캐시 또는 fallback을 사용해 홈 렌더링 완료
AI 추천 API가 모두 실패해 upstream 성공률이 0%더라도 stale 데이터가 있다면 홈 렌더링 성공률은 100%가 될 수 있습니다.
따라서 결과를 단순히 “성공률 100%”라고 표현하지 않고 다음 지표를 함께 확인했습니다.
- upstream success rate
- render success rate
- fresh cache hit rate
- stale fallback rate
- no-stale fallback rate
Before와 After 비교
Mock upstream에서 각 시나리오를 30회 반복해 측정했습니다.
시나리오 Before 평균 After 평균 Before p95 After p95 Before 성공률 After 렌더링 성공률 Cache hit Fallback
| normal | 0.06ms | 0ms | 0.08ms | 0ms | 100% | 100% | 100% | 0% |
| slow 1500ms | 1500.46ms | 0ms | 1501.24ms | 0ms | 100% | 100% | 100% | 0% |
| error | 0.33ms | 0.05ms | 0.54ms | 0.09ms | 0% | 100% | 0% | 100% |
| flaky 30% | 0.19ms | 0ms | 0.27ms | 0ms | 73% | 100% | 97% | 0% |
Slow 1500ms 시나리오
Before 구조에서는 upstream의 1.5초 지연이 추천 데이터 준비 시간에 그대로 반영됐습니다.
평균 추천 준비 시간: 1500.46ms
p95 추천 준비 시간: 1501.24ms
개선 전 홈 HTML 요청에서도 Request sent and waiting이 1.51초로 측정됐습니다. 서버가 AI 추천 결과를 기다린 시간이 initial document 응답 지연으로 이어진 것입니다.
After의 warm cache 조건에서는 upstream 호출을 생략했습니다.
평균 추천 준비 시간: 0ms 수준
cache hit rate: 100%
이는 AI API가 빨라진 것이 아니라, 동일한 조건의 반복 요청에서 API 호출 자체를 제거한 결과입니다.
Error 시나리오
Before에서는 30회 모두 upstream 오류로 처리됐습니다.
upstream success rate: 0%
render success rate: 0%
After에서는 stale 데이터를 사용해 추천 영역 렌더링을 유지했습니다.
upstream success rate: 0%
render success rate: 100%
stale fallback rate: 100%
AI 추천 API는 여전히 실패하고 있었지만, 그 실패가 홈 렌더링 실패로 이어지지 않도록 영향 범위를 제한했습니다.
Flaky 30% 시나리오
Before에서는 30회 중 8회가 실패해 성공률이 73%로 측정됐습니다.
After에서는 첫 번째 정상 응답을 저장한 뒤 fresh cache를 재사용해 렌더링 성공률을 100%로 유지했습니다.
render success rate: 100%
cache hit rate: 97%
다만 이 결과는 캐시가 준비된 warm 상태에서 반복 진입했을 때의 효과입니다. AI 추천 API 자체의 실패율이 낮아진 것은 아니며 캐시가 없는 최초 요청에서는 여전히 upstream 호출이 필요합니다.
현재 구조의 한계
이번 작업으로 반복 요청과 API 실패의 영향을 완화했지만 완전한 장애 격리 구조는 아니라고 생각합니다.
API 실패를 확인할 때까지 기다려야 한다
stale cache는 upstream 호출이 실패한 후에 조회됩니다.
따라서 AI 추천 API가 오류를 반환하기까지 오랜 시간이 걸리면 stale 데이터가 있어도 그 시간만큼 기다릴 수 있습니다. API timeout을 함께 설정해야 fallback 전환 시간을 제한할 수 있습니다.
동시 MISS가 중복 호출을 만들 수 있다
캐시가 만료된 순간 동일한 cache key의 요청이 동시에 들어오면 여러 요청이 모두 AI 추천 API를 호출할 수 있습니다.
이를 방지하려면 동일한 요청을 하나의 Promise로 합치는 single-flight 또는 request coalescing이 필요합니다.
동일한 cache key 요청 30개 발생
→ 실제 upstream 호출은 1회만 수행
→ 나머지 요청은 같은 Promise의 결과 공유
서버 메모리 캐시는 인스턴스 간 공유되지 않는다
현재 Map 캐시는 구현과 검증이 단순하고 조회 속도가 빠르지만 다음 한계가 있습니다.
- 서버가 재시작되면 캐시가 사라짐
- 여러 인스턴스가 서로 다른 캐시를 가짐
- 서버리스 환경에서 캐시 지속성을 보장하기 어려움
서비스 규모와 배포 환경이 확장되면 Redis와 같은 공유 캐시를 검토해야 합니다.
Circuit Breaker는 별도의 문제다
현재 구현은 실패 후 stale 데이터로 전환하지만, 장애가 반복되어도 API 호출 자체를 차단하지는 않습니다.
추후 장애 중 불필요한 호출까지 줄이려면 다음 상태를 관리하는 Circuit Breaker를 추가로 고려할 수 있습니다.
CLOSED
→ 정상적으로 API 호출

OPEN
→ API 호출 없이 즉시 fallback

HALF_OPEN
→ 일부 요청만 허용해 복구 여부 확인
다만 현재 단계에서는 캐시와 fallback만으로도 실제로 발생한 반복 호출과 홈 렌더링 실패 문제를 완화할 수 있었기 때문에 구현 복잡도를 고려해 Circuit Breaker까지 적용하지 않았습니다.
마치며
이번 작업에서 해결하려던 문제는 AI 추천 API 자체의 성능이 아니었습니다.
외부 의존성은 언제든 느려지거나 실패할 수 있습니다. 프론트엔드에서 제어하기 어려운 외부 API의 문제를 완전히 제거하기보다, 해당 문제가 홈 전체의 사용자 경험으로 전파되지 않도록 만드는 것이 더 현실적인 목표였습니다.
이를 위해 다음 전략을 적용했습니다.
- 30초 fresh cache로 반복 호출 제거
- 5분 stale fallback으로 장애 시 최근 추천 유지
- 캐시가 없으면 빈 추천 데이터로 추천 영역만 축소
- 구조화 로그로 정상 응답과 대체 응답 구분
- Mock upstream으로 지연·실패·간헐적 장애 재현
- 평균·p95·cache hit·fallback 비율로 개선 효과 검증
개선 전 추천 데이터 준비 시간은 평균 1500.46ms였으며 실제 홈 HTML 요청에서도 서버 응답 대기 시간이 1.51초로 측정됐습니다.
개선 후 warm cache 조건에서는 upstream 호출을 생략해 추천 준비 시간을 메모리 조회 수준으로 줄였습니다.
Error 시나리오에서는 AI 추천 API의 성공률이 0%였지만, stale fallback을 통해 홈 렌더링 성공률을 100%로 유지했습니다.
올리브영 기술 블로그에서 인상 깊었던 원칙은 다음 문장이었습니다.
어떠한 환경에서도 Home은 노출되어야 한다.
본 서비스의 규모와 적용 기술은 다르지만, 이번 작업도 같은 방향을 목표로 했습니다.
추천 데이터는 최신일수록 좋지만 추천 시스템의 장애가 홈의 장애가 되어서는 안 된다.
앞으로는 timeout과 single-flight를 적용해 cold cache 요청의 대기 시간과 동시 요청을 제어하고, 운영 환경에 따라 공유 캐시로 확장하는 방안을 검토할 예정입니다.
참고 자료
'[FE]' 카테고리의 다른 글
| [A/B 테스트] “감”이 아니라 “증명”으로 만드는 방법 (0) | 2026.02.24 |
|---|---|
| [디자인 시스템] TypeScript + Tailwind CSS 4.0 환경에서 구축하기 (0) | 2026.02.14 |
| [Storybook] 도입과 운영 기록 (0) | 2026.02.09 |
| FSD 아키텍처 적용기: 코드 위치를 설계하다 (0) | 2026.02.08 |
| Next.js App Router에서 BFF 레이어를 구성한 방법과 고민 (0) | 2026.01.25 |


