
| 일 | 월 | 화 | 수 | 목 | 금 | 토 |
|---|---|---|---|---|---|---|
| 1 | 2 | 3 | ||||
| 4 | 5 | 6 | 7 | 8 | 9 | 10 |
| 11 | 12 | 13 | 14 | 15 | 16 | 17 |
| 18 | 19 | 20 | 21 | 22 | 23 | 24 |
| 25 | 26 | 27 | 28 | 29 | 30 | 31 |
- 데이터캐싱
- frontend
- 최적화
- react성능최적화
- NextImage
- JWT
- fe
- 성능최적화
- Refactoring
- 리팩토링
- reactquery
- JavaScript
- NextJs
- Next
- 프론트엔드성능
- 이미지최적화
- 프론트엔드개발자
- TanStackQuery
- react
- lighthouse
- WebP
- refresh token
- useEffect
- 프론트엔드개발
- RTR
- TechBlog
- 리액트
- frontenddevelopment
- 프론트엔드
- 비동기처리
- Today
- Total
juncci 님의 블로그
Map으로 구현한 인메모리 캐시와 대규모 트래픽에서의 관리 본문
프로젝트에서 홈 화면의 추천 데이터를 Server Component에서 가져오는 과정에서 추천 API의 응답 지연이 전체 SSR 응답 시간에 영향을 주는 문제가 있었다.
홈은 계속 보여야 한다: SSR 환경에서 AI 추천 API의 지연과 실패에 대응하기
RE-FIT 서비스 홈에는 사용자에게 적합한 전문가를 보여주는 AI 기반 추천 영역이 있습니다. 추천 데이터를 첫 화면부터 제공하기 위해 해당 영역은 클라이언트에서 별도로 요청하는 구조가 아니
juncci.tistory.com
추천 데이터는 홈 화면에서 반드시 필요한 핵심 콘텐츠는 아니었기 때문에 추천 API가 느려지거나 일시적으로 장애가 발생했다는 이유로 홈 전체의 응답이 영향을 받는 구조를 줄이고자 했다.
이를 위해 추천 결과를 서버 메모리에 저장하는 간단한 인메모리 캐시를 구현했다.
정상적인 상황에서는 30초 동안 동일한 추천 결과를 재사용하고 30초가 지나면 새로운 데이터를 요청한다.
이때 추천 API 요청에 실패하면 기존 데이터가 5분 이내인 경우 fallback으로 활용하도록 구성했다.
Fresh TTL        30초
Stale fallback    5분
최대 엔트리       500개
처음 구현했을 때의 관심사는 명확했다.
- 짧은 시간 내 반복되는 추천 API 호출 감소
- 추천 API 지연이 SSR 전체에 미치는 영향 감소
- 추천 API 장애 시 기존 데이터를 이용한 홈 렌더링 보호
하지만 이후 캐시 구조를 다시 살펴보면서 의문이 생겼다.
현재처럼 서버 프로세스의 메모리에 데이터를 저장하는 방식이 트래픽이 증가하고 서버가 여러 개로 확장되는 환경에서도 적절할까?
이번 글에서는 기존 구현을 다시 살펴보면서 인메모리 캐시의 수명과 메모리 관리, eviction, cache hit rate, cache stampede, Lambda 환경에서의 캐시 분산까지 범위를 넓혀 정리해 보았다.
1. 기존 인메모리 캐시의 동작 구조
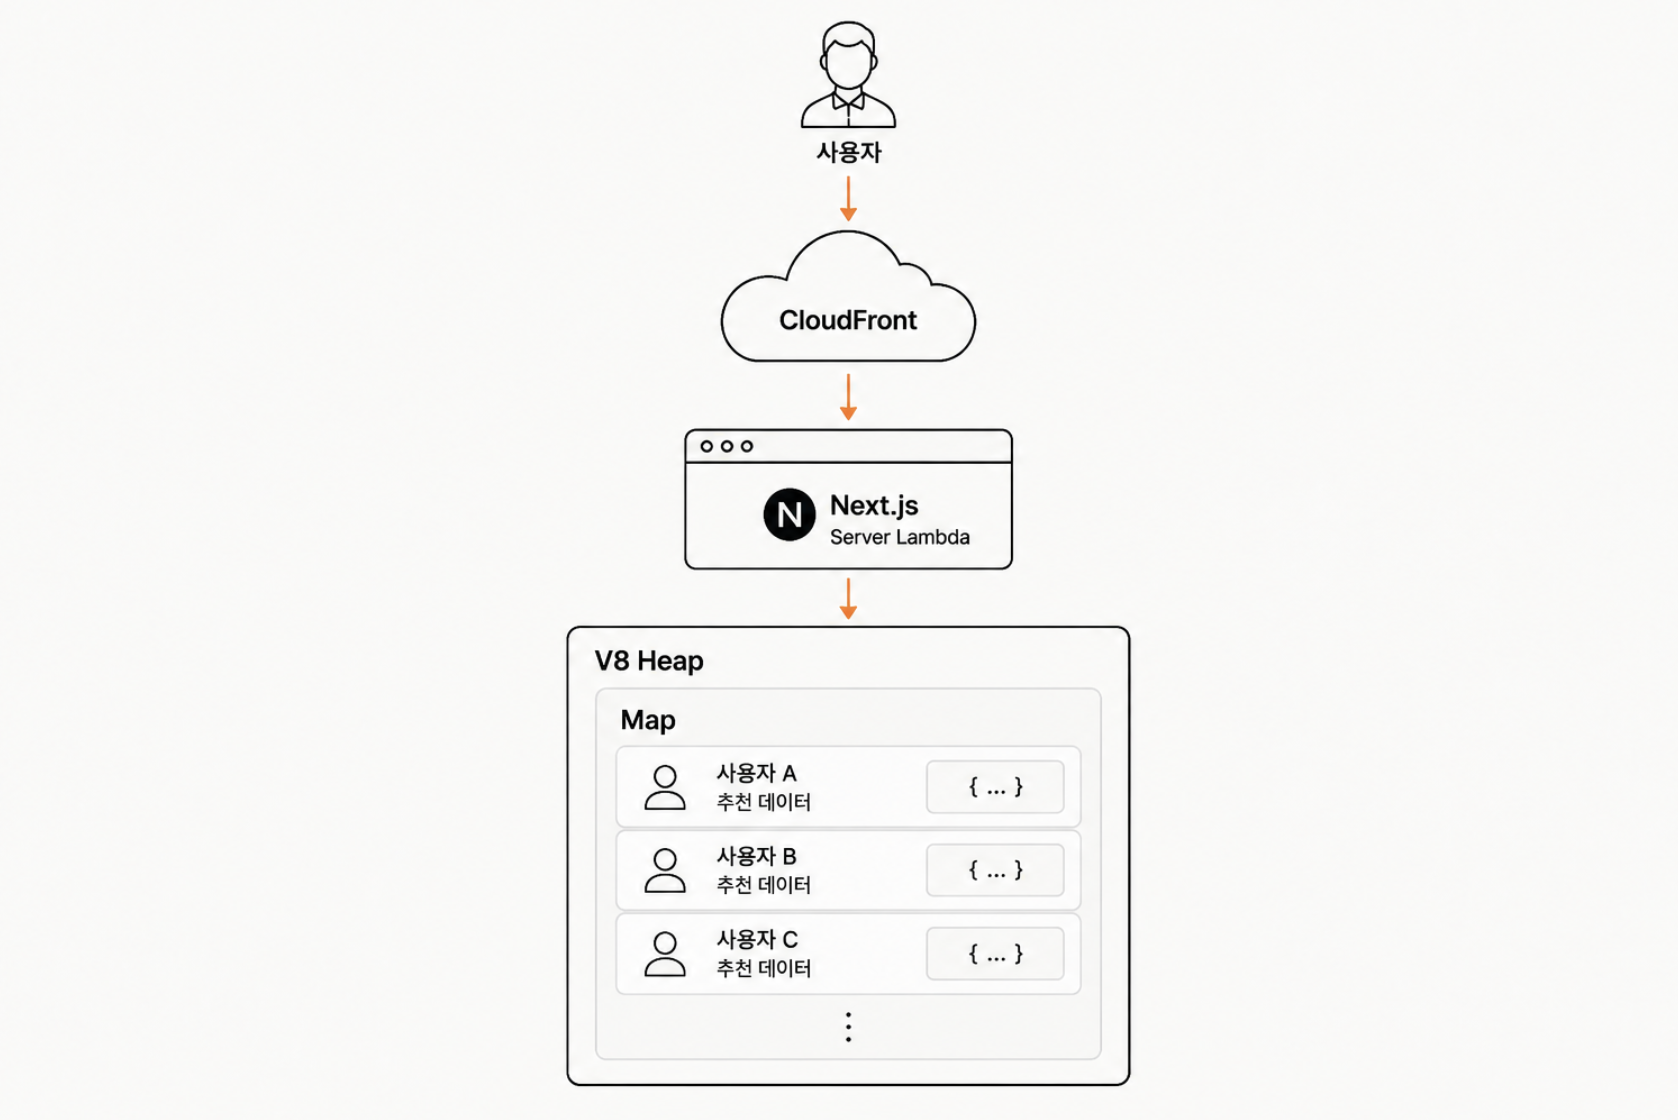
현재 추천 데이터는 서버 모듈에 선언한 Map에 저장된다.
전체 구조를 단순화하면 다음과 같다.
여기서 Map은 별도의 저장소가 아니다.
Node.js 프로세스에서 생성한 JavaScript 객체이기 때문에 캐시 데이터 역시 Node.js가 사용하는 V8 Heap에 존재한다.
추천 결과는 사용자별로 다르기 때문에 사용자와 요청 조건을 기준으로 캐시를 구분했다.
개념적으로는 다음과 같은 구조다.
사용자 식별값 :: query
캐시 데이터에는 추천 결과와 함께 저장 시점을 기록한다.
이를 이용해 요청이 들어왔을 때 데이터가 얼마나 오래됐는지 판단한다.
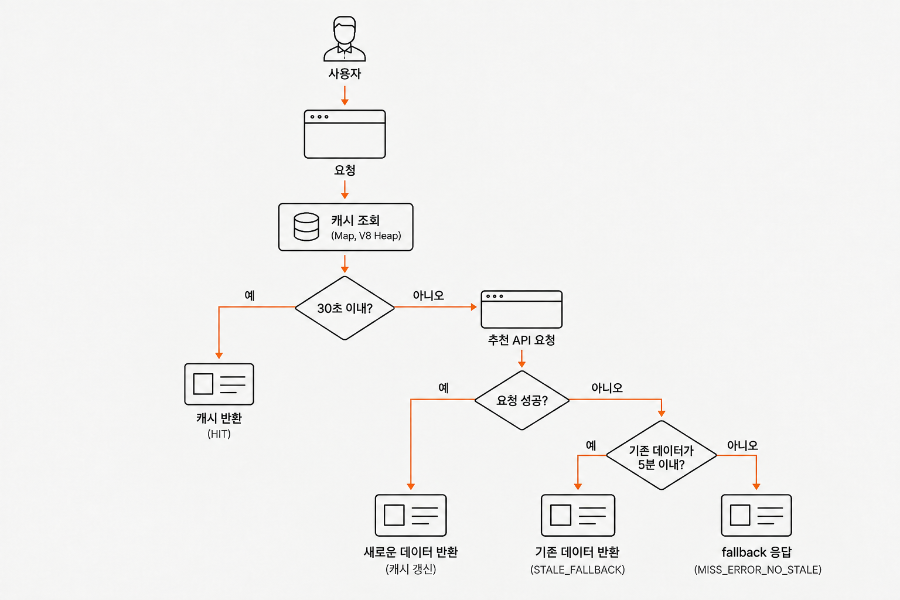
여기서 30초와 5분은 서로 다른 역할을 가진다.
30초는 정상적인 상황에서 데이터를 재사용하는 기간이고, 5분은 장애 상황에서만 허용하는 기존 데이터의 최대 수명이다.
2. TTL 만료와 메모리 해제의 차이
캐시를 다시 살펴보면서 가장 먼저 확인한 부분은 TTL이었다.
처음에는 TTL이 지나면 캐시 데이터 역시 자연스럽게 제거된다고 생각하기 쉽다.
하지만 현재 코드에서 TTL은 데이터의 유효성을 판단하는 기준일 뿐 메모리에서 데이터를 삭제하는 기준은 아니다.
개념적으로 다음과 같은 코드다.
if (Date.now() - cached.cachedAt > maxAgeMs) {
  return { hit: false, body: null };
}
30초가 지났다면 해당 데이터를 더 이상 정상적인 cache hit로 사용하지 않는다.
하지만 여기에는 Map.delete()가 없다.
따라서 실제 Map은 다음과 같은 상태가 될 수 있다.
Map

User A → expired
User B → fresh
User C → expired
User D → fresh
A와 C는 정상적인 응답에는 사용할 수 없지만 여전히 Map에 존재한다.
JavaScript의 Garbage Collector 역시 해당 데이터가 만료됐다는 애플리케이션의 의미를 알지 못한다.
Map이 해당 객체를 계속 참조하고 있기 때문이다.
따라서 TTL과 데이터 제거는 구분해서 생각해야 한다.
TTL
└─ 데이터를 언제까지 유효하다고 판단할 것인가

Eviction
└─ 어떤 데이터를 실제 캐시에서 제거할 것인가
TTL이 있다고 해서 메모리 관리까지 자동으로 해결되는 것은 아니었다.
3. 캐시 용량 제한과 데이터 제거 방식
현재 구현에는 캐시가 무한하게 증가하지 않도록 최대 500개의 엔트리 제한을 두었다.
캐시가 500개에 도달하면 가장 먼저 삽입된 데이터를 제거한 뒤 새로운 데이터를 저장한다.
개념적으로는 다음과 같다.
if (cache.size >= MAX_CACHE_ENTRIES) {
  const firstKey = cache.keys().next().value;

  cache.delete(firstKey);
}

cache.set(key, data);
따라서 현재 캐시는 무한히 증가하는 구조는 아니다.
MAX = 500

1
2
3
...
499
500

새로운 데이터 저장
      ↓
기존 데이터 하나 제거
      ↓
500개 유지
다만 여기서 한 가지 문제가 있었다.
현재 제거 기준은 사용 빈도가 아니라 삽입 순서다.
예를 들어 A → B → C 순서로 데이터가 저장됐다고 해보자.
A → B → C
이후 A가 계속 사용됐더라도 Map의 삽입 순서는 바뀌지 않는다.
새로운 D를 저장해야 한다면 가장 먼저 저장된 A가 제거될 수 있다.
A → 매우 자주 사용됨
B → 거의 사용되지 않음
C → 최근 사용됨

새로운 D 저장

A 제거
따라서 현재 정책은 LRU보다는 최대 엔트리 수를 제한한 FIFO eviction에 가깝다.
4. 캐시 재사용을 고려한 LRU 정책
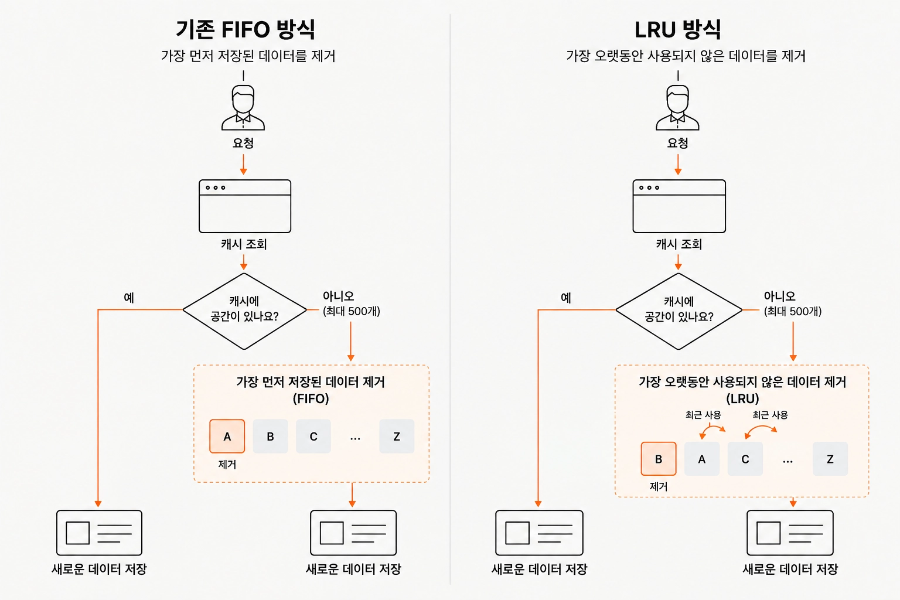
캐시의 공간이 제한되어 있다면 어떤 데이터를 남길 것인지도 중요하다.
대표적인 방법 중 하나가 LRU(Least Recently Used)다.
LRU는 가장 먼저 저장된 데이터가 아니라 가장 오랫동안 사용되지 않은 데이터를 제거한다.
예를 들어 최대 세 개를 저장할 수 있다고 가정한다.
A
B
C
이후 A와 C가 다시 조회됐다면 사용 순서는 달라진다.
최근 사용

C
A
B ← 가장 오래 사용되지 않음
이 상태에서 D가 들어오면 B를 제거한다.
B 제거

C
A
D
자주 조회되는 데이터가 오래전에 저장됐다는 이유만으로 제거되는 것을 막을 수 있다.
현재 프로젝트의 FIFO 방식도 500개라는 상한을 두어 무제한 증가를 방지한다는 목적은 달성한다.
하지만 실제 트래픽에서 특정 추천 결과가 반복적으로 사용된다면 LRU가 cache hit rate 측면에서 더 효과적인지는 검토할 필요가 있다.
여기서 중요한 것은 LRU가 항상 FIFO보다 좋다고 단정할 수 없다는 것이다.
실제 요청 패턴을 측정한 뒤 어떤 정책이 적절한지 판단해야 한다.
5. 엔트리 개수와 실제 메모리 사용량
500개라는 제한이 있다면 메모리 문제도 해결됐다고 볼 수 있을까?
엔트리 수만으로는 판단하기 어렵다.
같은 500개의 데이터라도 각 응답의 크기에 따라 필요한 메모리가 크게 달라진다.
단순하게 계산해도 다음과 같다.
평균 응답 20KB

20KB × 500
≈ 10MB
평균 응답 500KB

500KB × 500
≈ 250MB
둘 다 cache.size는 500이다.
게다가 JavaScript 객체가 실제 Heap에서 차지하는 크기는 JSON 문자열의 크기와 정확히 동일하지 않다.
따라서
cache.size = 500
이라는 정보만으로는 캐시가 메모리를 얼마나 사용하는지 알 수 없다.
실제 운영 환경에서는 다음과 같은 값을 함께 확인할 필요가 있다.
Cache Entry Count
Average Entry Size

        +

process.memoryUsage().heapUsed
process.memoryUsage().rss
엔트리 개수에 대한 상한과 메모리 사용량에 대한 상한은 다른 문제였다.
현재 프로젝트는 전자는 가지고 있지만 후자는 아직 측정하지 않은 상태다.
6. 캐시 효율을 판단하는 Hit Rate
캐시를 많이 저장한다고 해서 반드시 좋은 것은 아니다.
캐시의 목적은 데이터를 저장하는 것 자체가 아니라 반복되는 원본 요청을 줄이는 것이기 때문이다.
예를 들어 10,000개의 요청 중 HIT 8000, MISS 2000이라면 Hit Rate: 80%가 된다.
HIT   8,000
MISS  2,000
Hit Rate = 80%
상당수의 추천 API 호출을 캐시에서 처리하고 있다는 의미다.
반대로
HIT     500
MISS  9,500
이라면 Hit Rate는 5%에 불과하다.
서버 메모리를 사용해 데이터를 저장하고 있지만 대부분의 요청이 결국 추천 API까지 전달된다.
현재 추천 캐시는 사용자별로 분리되어 있고 fresh TTL도 30초로 짧다.
사용자별 Cache Key
        +
30초 Fresh TTL
따라서 사용자가 30초 안에 다시 홈에 접근하지 않는다면 한 번 저장된 데이터가 다시 사용되지 않을 수도 있다.
얼마나 많은 데이터를 캐싱하고 있는가가 아니라 저장한 데이터가 실제로 얼마나 다시 사용되고 있는가가 중요한 것 같다.
그래서 캐시를 평가할 때는 최소한 다음 지표를 함께 살펴볼 필요가 있다.
Cache Hit Rate
Cache Miss Rate
Eviction Count
Cache Entry Count
Upstream Request Count
7. 동시 MISS와 Cache Stampede
메모리 관리뿐 아니라 요청이 한 번에 몰리는 상황도 고려할 필요가 있었다.
예를 들어 동일한 캐시 데이터가 만료되는 순간 여러 요청이 동시에 들어왔다고 가정한다.
              Cache Expired

Request A ───────┐
Request B ───────┤
Request C ───────┼──▶ Recommendation API
Request D ───────┤
Request E ───────┘
각 요청은 거의 동시에 캐시가 만료됐다는 사실을 확인한다.
그리고 현재 구조에서는 각 요청이 독립적으로 추천 API를 호출할 수 있다.
결과적으로 같은 데이터를 얻기 위한 요청이 동시에 여러 번 발생한다.
이러한 문제를 Cache Stampede 또는 Thundering Herd라고 부른다.
프로세스 내부에서는 동일한 key에 대한 진행 중 요청 자체를 저장하는 방법을 생각해볼 수 있다.
Request A ──▶ API Request
                ▲
                │
Request B ──────┤
Request C ──────┤
Request D ──────┘
Map<string, Promise<Result>>
형태로 진행 중인 요청을 저장하면 같은 key에 대한 두 번째 요청부터 기존 Promise를 기다리게 할 수 있다.
이를 request coalescing 또는 single-flight 방식으로 볼 수 있다.
다만 이것도 프로세스 내부에서만 동작한다는 한계가 있다.
8. Lambda 확장과 인메모리 캐시의 분산
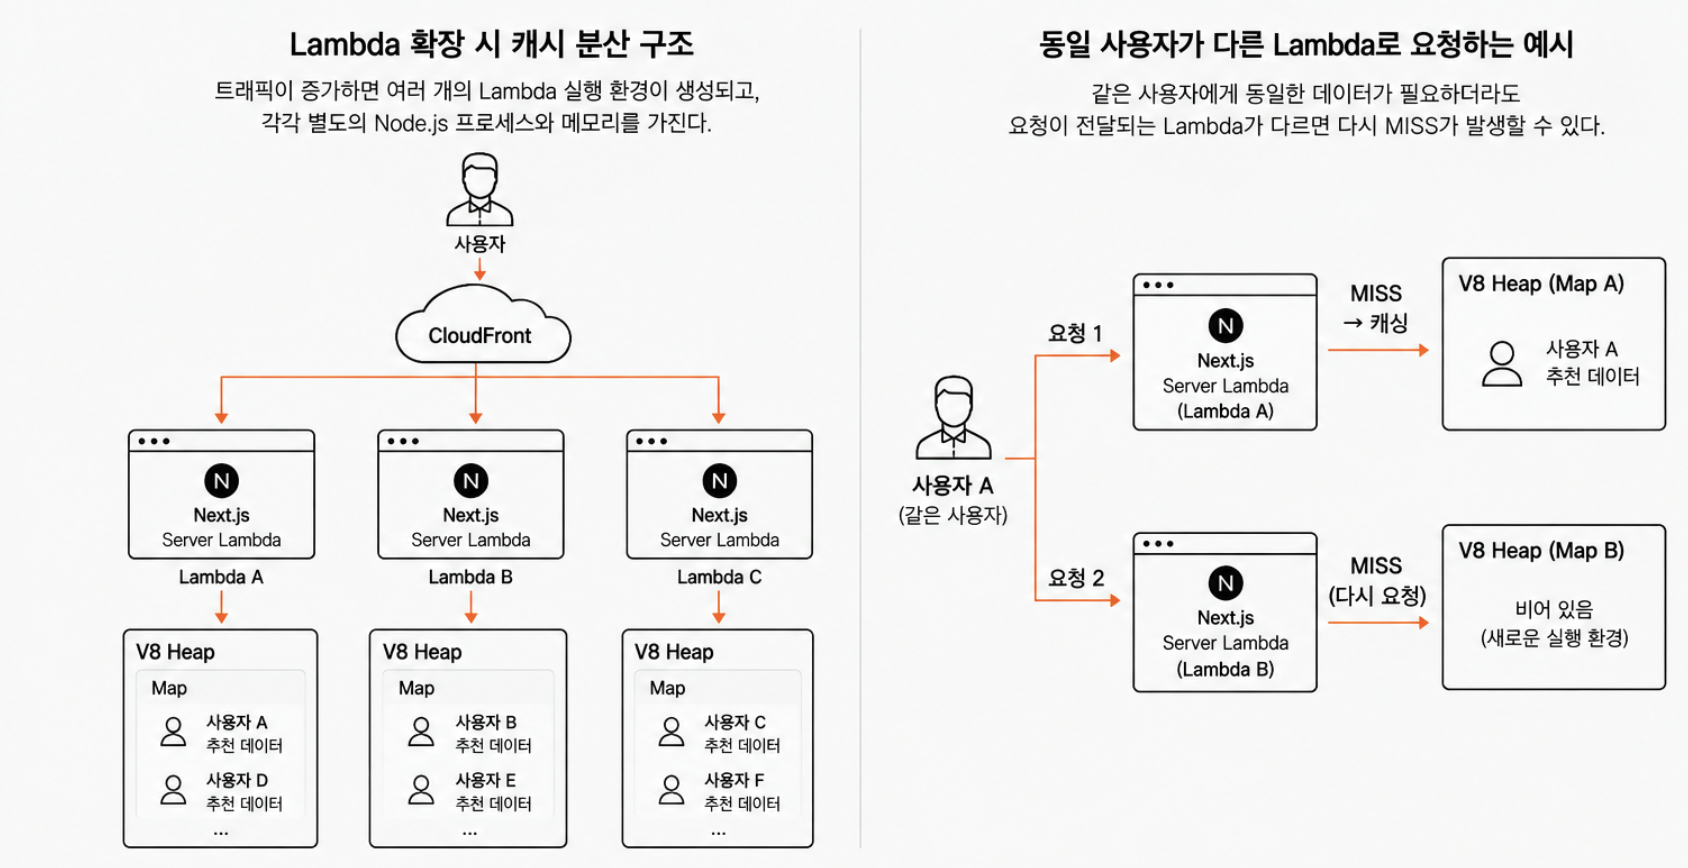
현재 프로젝트는 AWS Lambda 환경에서 Next.js 서버가 실행된다.
여기서 로컬 인메모리 캐시의 중요한 특성이 나타난다.
트래픽이 증가해 Lambda 실행 환경이 여러 개 생성되면 각각 별도의 Node.js 프로세스와 메모리를 가진다.
                    CloudFront
                 /      |      \
                ▼       ▼       ▼
           Lambda A Lambda B Lambda C
               │       │       │
             Map A   Map B   Map C
Map A에 저장된 데이터를 Map B가 사용할 수 있는 것은 아니다.
사용자 A
  │
  ├─ 요청 1 → Lambda A
  │            └─ MISS → 캐싱
  │
  └─ 요청 2 → Lambda B
               └─ MISS
같은 사용자에게 동일한 데이터가 필요하더라도 다른 Lambda로 요청이 전달되면 다시 MISS가 발생할 수 있다.
또한 새로운 Lambda 실행 환경은 빈 Map에서 시작한다.
반대로 기존 실행 환경이 재사용된다면 이전 요청에서 저장한 Map이 남아 있을 수 있다.
따라서 인메모리 캐시는 Lambda 환경에서
인스턴스 증가
     ↓
캐시 분산
     ↓
동일 데이터 중복 저장
     ↓
Cache Hit Rate 감소 가능성
     ↓
Upstream 요청 증가 가능성
이라는 특성을 갖게 된다.
이 때문에 로컬 환경이나 하나의 서버에서 확인한 cache hit rate만으로 실제 확장 환경에서의 효과를 판단하기는 어렵다.
9. 다중 인스턴스 환경과 공유 캐시
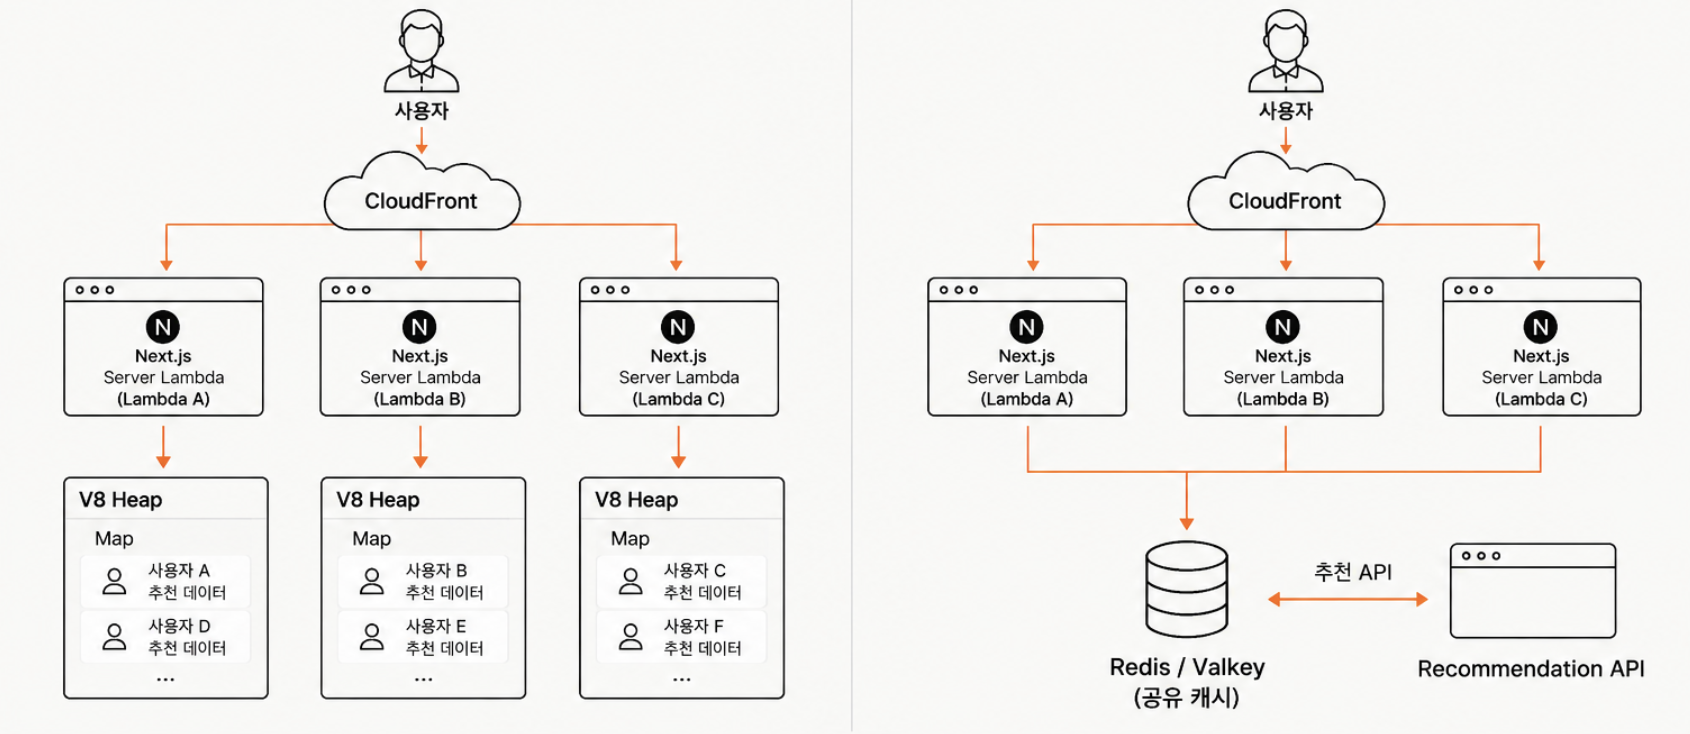
여러 서버에서 동일한 캐시를 활용해야 한다면 Redis나 Valkey 같은 외부 공유 캐시를 고려할 수 있다.
현재 구조가
Lambda A → Map A
Lambda B → Map B
Lambda C → Map C
라면 공유 캐시를 사용하는 구조는 다음과 같이 달라진다.
Lambda A ─┐
Lambda B ─┼──▶ Redis / Valkey ──▶ Recommendation API
Lambda C ─┘
여러 Lambda가 같은 캐시를 조회할 수 있기 때문에 인스턴스별 데이터 중복과 분산된 cache hit 문제를 줄일 수 있다.
또한 캐시 데이터가 애플리케이션의 V8 Heap에서 분리된다는 장점도 있다.
하지만 여기서도 바로 Redis를 도입하는 것이 항상 정답은 아닌 것 같다.
외부 캐시가 추가되면
애플리케이션
      │
      │ Network I/O
      ▼
Redis / Valkey
네트워크 비용이 발생하고 캐시 서버 자체의 장애와 운영 비용도 고려해야 한다.
무엇보다 현재 로컬 캐시의 hit rate 자체가 낮다면 저장 위치를 Redis로 옮겨도 캐싱 효과가 크지 않을 수 있다.
따라서 대규모 트래픽을 가정했다고 바로 외부 캐시를 도입하기보다 현재 캐시가 실제로 얼마나 효과적인지 측정하는 과정이 먼저 필요하다.
10. 캐시 운영을 위한 관측 지표
현재 프로젝트에서는 캐시 요청을 다음과 같은 상태로 구분하고 있다.
HIT
MISS_FETCHED
BYPASS_FETCHED
STALE_FALLBACK
MISS_ERROR_NO_STALE
이를 통해 특정 요청이 캐시를 사용했는지, API를 호출했는지, 장애 상황에서 stale 데이터를 사용했는지를 확인할 수 있다.
하지만 대규모 트래픽 환경에서 캐시의 효과와 안정성을 판단하려면 이것만으로는 부족하다.
추가로 다음과 같은 지표를 확인할 필요가 있다.
지표 확인 목적
| Cache Hit Rate | 캐시가 실제로 재사용되는 비율 |
| Cache Miss Rate | 원본 API까지 전달되는 비율 |
| Cache Entry Count | 현재 저장된 데이터 개수 |
| Average Entry Size | 캐시 데이터 하나의 평균 크기 |
| Heap Used | JavaScript Heap 사용량 |
| RSS | Node.js 프로세스 전체 메모리 사용량 |
| Eviction Count | 용량 제한으로 데이터가 제거되는 빈도 |
| Upstream Request Count | 캐시로 실제 API 요청을 얼마나 줄였는지 |
| Stale Fallback Rate | 장애 시 기존 데이터가 사용되는 비율 |
| Concurrent Miss | 동일 key에 요청이 동시에 몰리는 정도 |
이러한 데이터를 확보하면 캐시 전략을 감이 아니라 실제 요청 패턴을 기준으로 결정할 수 있다.
Hit Rate 높음
메모리 안정적
        │
        ▼
현재 인메모리 캐시 유지

Hit Rate 높음
Eviction 빈번
        │
        ▼
LRU 등 제거 정책 검토

메모리 사용량 과도
        │
        ▼
Entry 크기 및 메모리 제한 검토

다중 Lambda에서
중복 MISS 증가
        │
        ▼
공유 캐시 검토
11. 기존 캐시 구조에서 확장된 고려사항
처음 캐시를 구현했을 때 해결하려던 문제는 비교적 명확했다.
추천 API 반복 호출
        +
추천 API 지연 및 장애
        ↓
홈 SSR에 영향
30초 Fresh Cache
        +
5분 Stale Fallback
        +
500개 Entry 제한
이 구조는 짧은 시간 내 반복되는 추천 요청을 줄이고 추천 API 장애가 홈 전체로 전파되는 것을 방지하기 위한 국소적인 캐시로 시작했다.
하지만 트래픽 규모를 확장해서 생각하자 고려해야 할 범위도 넓어졌다.
TTL
 ↓
메모리 해제
 ↓
Eviction
 ↓
메모리 사용량
 ↓
Cache Hit Rate
 ↓
Cache Stampede
 ↓
Lambda Scale-out
 ↓
Distributed Cache
단일 요청의 응답 시간을 줄이기 위한 캐시가 서버의 메모리 관리와 요청 패턴을 거쳐 결국 분산 시스템의 문제까지 연결되는 것이다.
마무리
처음에는 인메모리 캐시를 반복되는 API 요청을 줄이기 위한 간단한 성능 최적화로 바라봤다.
하지만 기존 구현을 다시 살펴보면서 TTL이 있다고 데이터가 자동으로 메모리에서 제거되는 것은 아니며, 최대 엔트리 수를 제한했다고 적절한 데이터가 제거되는 것도 아니라는 점을 확인했다.
또한 단일 프로세스에서는 효과적인 캐시라도 Lambda가 여러 실행 환경으로 확장되면 각 인스턴스에 캐시가 분산된다. 이 과정에서 동일한 데이터가 중복 저장되고 cache hit rate가 달라지거나 동시에 여러 MISS가 발생하는 문제까지 고려해야 했다.
그렇다고 현재 구조를 바로 LRU나 Redis로 변경하는 것이 이번 학습의 결론은 아니다.
현재 프로젝트에는 500개의 엔트리 제한이 있지만 실제 캐시가 몇 MB를 사용하는지, 프로덕션 환경에서 cache hit rate가 얼마인지, 캐시를 통해 추천 API 호출을 얼마나 줄이고 있는지에 대한 데이터는 아직 충분하지 않다.
따라서 다음 단계는 기술을 추가하는 것보다 다음 지표를 실제 환경에서 확인하는 것이다.
Cache Hit Rate
Heap / RSS
Average Entry Size
Eviction Count
Concurrent Miss
Upstream Request 감소량
그 결과를 바탕으로 현재 로컬 캐시를 유지할지, LRU와 같은 eviction 정책을 적용할지, 여러 Lambda가 공유할 수 있는 Redis나 Valkey 같은 외부 캐시가 필요한지를 결정할 수 있다.
'[FE]' 카테고리의 다른 글
| [EP.2][Web Work] OffscreenCanvas로 이미지 처리하기 (0) | 2026.07.23 |
|---|---|
| [EP.1][Web Work] Web Worker의 개념과 동작 원리 (0) | 2026.07.15 |
| 패키지 매니저 비교: pnpm을 선택한 이유 (0) | 2026.04.15 |
| [TanStack Query] Lv.3 TanStack Query 적용 (0) | 2026.04.13 |
| [TanStack Query] Lv.2 코드로 구현한 수치 기반 캐싱 (0) | 2026.04.08 |


